Navegación
Instala la aplicación
Cómo instalar la aplicación en iOS
A continuación, siga el video para ver cómo instalar este sitio como una aplicación web en su pantalla de inicio.
Nota: This feature may not be available in some browsers.
Más opciones
Estás utilizando un navegador obsoleto. Puede que este u otros sitios no se muestren correctamente.
Debes actualizarlo o utilizar un navegador alternativo.
Debes actualizarlo o utilizar un navegador alternativo.
Así conseguí CLAUDE GRATIS + ILIMITADO
- Iniciador del tema Salvaje
- Fecha de inicio
Rafa Oteiza
Humano
- 23 Sep 2026
- 1
- 0
Hola !
Buenísimo tutorial y bien explicado
Me entró una duda si se puede realizar lo mismo con ChatGtp
Se podrá?
Saludos !
Buenísimo tutorial y bien explicado
Me entró una duda si se puede realizar lo mismo con ChatGtp
Se podrá?
Saludos !

Salvaje
Pastilla roja
- 20 Mar 2026
- 98
- 91
- Iniciador del tema
- #4
claro, mira
desde el cmd escribes esto para eliminar el modelo que se instalo:
ollama rm gemma4:26b
Igual te quedaste sin espacio en disco, con borrar el modelo quitas los 19GB de su peso
y luego si quieres eliminar Claude Code seria esto:
del "%USERPROFILE%\.local\bin\claude.exe"
rmdir /s /q "%USERPROFILE%\.local\share\claude"
Para desinstalar también la aplicación Ollama sigue esta ruta en Windows:
Configuración de Windows → Aplicaciones → Aplicaciones instaladas → Ollama → Desinstalar
Estos son los pasos que yo seguí para desinstalarlo y poder mostrar el proceso desde 0 en el video, debería funcionarte, pero ten cuidado de no borrar nada que no quieras eliminar
Salvaje
Pastilla roja
- 20 Mar 2026
- 98
- 91
- Iniciador del tema
- #6
En el video digo que consume bastantes recursos y que puede tardar en responder, incluso hacemos una prueba y se muestra lo que tarda
Aun así es cierto que no profundice en los requisitos necesarios porque mi intención era enseñar como conseguí ejecutar Claude con un modelo gratuito e ilimitado, de ahí el titulo del video
Igualmente te agradezco el comentario y lo tendré en cuenta para próximos videos en los que hable de ejecutar IA de forma local

Hola. Llegué hasta la parte donde dices que es mejor crear una carpeta para claude y que no quede en USERS. Y en esta parte es que no me sale igual ya que vuelve muy atrás y muestra otra cosa y no da la opción de incorporar una carpeta como tu lo explicas¿Cuántas veces has leído que la IA cada vez va a ser mas cara?
Seguro que no pocas
porque es verdad
Por eso en mi vuelta YouTube te explico paso a paso un trucazo para tener Claude
- 100% GRATIS
- 100% PRIVADO
- 100% EN LOCAL
- 100% ILIMITADO
Te lo de aquí!!
Archivos adjuntos
-
Imagen adjunta Ver imagen →
 17910823069284932073784204087969.webp973,9 KB · 9 visualizaciones
omillar440
Humano
- 13 Oct 2026
- 1
- 0
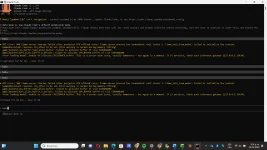
me sale error, no puedo seguir , me puedes colaborar por favor
Archivos adjuntos
-
Imagen adjunta Ver imagen →
 Captura de pantalla 2026-10-13 064533.webp218,3 KB · 6 visualizaciones
Hola muy buenas tardes, hice todos los pasos pero me sale esto "
API Error: 500 llama-server startup failed after projector CPU offload retry: llama-server
process has terminated: exit status 1: llama_init_from_model: failed to initialize the
context: Gemma4Assistant requires ctx_other to be set (this warning is normal during memory
fitting)
ggml_backend_cpu_buffer_type_alloc_buffer: failed to allocate buffer of size 5246484480
ggml_backend_buft_alloc_buffer_n_default: failed to allocate CPU_REPACK buffer of size
5246484480
error loading model: unable to allocate CPU_REPACK buffer. This is a server-side issue,
usually temporary — try again in a moment. If it persists, check your inference gateway
(127.0.0.1:11434)." será que hice algo mal o es que mi computador no lo aguanto.
Muchas gracias agradecería demasiado de su colaboracion.
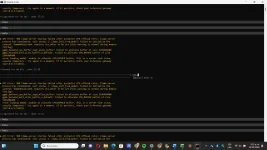
API Error: 500 llama-server startup failed after projector CPU offload retry: llama-server
process has terminated: exit status 1: llama_init_from_model: failed to initialize the
context: Gemma4Assistant requires ctx_other to be set (this warning is normal during memory
fitting)
ggml_backend_cpu_buffer_type_alloc_buffer: failed to allocate buffer of size 5246484480
ggml_backend_buft_alloc_buffer_n_default: failed to allocate CPU_REPACK buffer of size
5246484480
error loading model: unable to allocate CPU_REPACK buffer. This is a server-side issue,
usually temporary — try again in a moment. If it persists, check your inference gateway
(127.0.0.1:11434)." será que hice algo mal o es que mi computador no lo aguanto.
Muchas gracias agradecería demasiado de su colaboracion.
Tu computador no lo aguanto el equipo no hizo nada mal en el procedimiento de instalacion sino que los recursos de hardware (la memoria RAM) se quedo corto para procesar y cargar los más de 5 GB que exige el modelo en ese búfer.Hola muy buenas tardes, hice todos los pasos pero me sale esto "
API Error: 500 llama-server startup failed after projector CPU offload retry: llama-server
process has terminated: exit status 1: llama_init_from_model: failed to initialize the
context: Gemma4Assistant requires ctx_other to be set (this warning is normal during memory
fitting)
ggml_backend_cpu_buffer_type_alloc_buffer: failed to allocate buffer of size 5246484480
ggml_backend_buft_alloc_buffer_n_default: failed to allocate CPU_REPACK buffer of size
5246484480
error loading model: unable to allocate CPU_REPACK buffer. This is a server-side issue,
usually temporary — try again in a moment. If it persists, check your inference gateway
(127.0.0.1:11434)." será que hice algo mal o es que mi computador no lo aguanto.
Muchas gracias agradecería demasiado de su colaboracion.
Ver el archivos adjunto 253
Hola!!, muchas gracias por todo el contenido del video. He intentado hacer el paso a paso, pero a la hora de instalar la versión de Gemma4 que a mi me aparece es la 12b, no me aparece como en el video, una vez descargada, al ejecutarse me dice que Gemma4:12b no se reconoce y no he logrado hacer que Claude me responda, se queda más de 2 y de 3 minutos pensando, lo que me hace creer que se ha bloqueado. Me gustaría saber cómo poder solucionar este problema para poder utilizarlo de forma local tal y como se indica en el video. Quedo a la espera, gracias por las aportaciones. Un saludo.¿Cuántas veces has leído que la IA cada vez va a ser mas cara?
Seguro que no pocas
porque es verdad
Por eso en mi vuelta YouTube te explico paso a paso un trucazo para tener Claude
- 100% GRATIS
- 100% PRIVADO
- 100% EN LOCAL
- 100% ILIMITADO
Te lo de aquí!!